
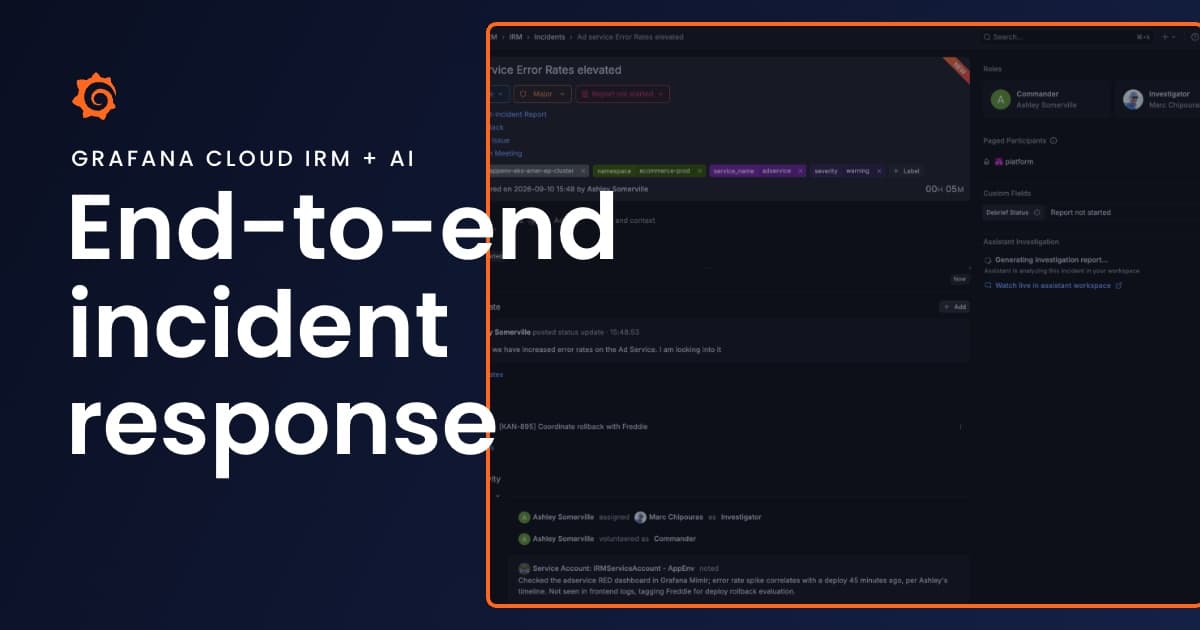
アラートからポストインシデントレビューまで:Grafana Cloud IRMとAIで実現するインシデント対応


このような状況を想像してください。次の会議まで10分というときに、電話が鳴り始めます。フロントエンドでAPIリクエストが失敗しているとして、あなたが呼び出されました。
まず1つのツールを開いて何が発火したかを確認し、次に別のツールを開いて状況を調べます。Slackでチームメンバーにメッセージを送り、同じ現象に気づいたか確認します。
作業のたびにコンテキストを切り替えながら、今も多くのチームがこのような形でインシデント対応を進めています。別のツールを開いて誰かに状況を共有するだけでも、相応の時間が必要です。コンテキストをある場所から別の場所へ手作業でコピーすれば、詳細が抜け落ちることもあるでしょう。
こんなやり方を続ける必要はありません。Grafana Cloud IRMでは、オンコール支援、インシデント管理、SlackやMicrosoft TeamsでのChatOps連携、調査、そしてGrafanaモバイルアプリが、インシデントレコードを通じてすべてつながります。
では、フロントエンドインシデントを例に、アラート発生から対応、ポストインシデントレビューまでの一連の流れをシナリオ形式で見ていきましょう。皆さんが今日からプロセスを改善するためのヒントが見つかるはずです。
呼び出しの時点で、すでにコンテキストがそろっている
呼び出されたときに必要なのは、問題がどれほど深刻か、最初に何を確認すべきかを把握することです。Grafana Cloud IRMなら、手がかりがアラート名だけ、という状態から対応を始める必要はありません。
アラートグループを開くと、影響を受けているサービス、アラートに紐づくダッシュボードのパネル、その履歴、この呼び出しにまとめられた個々のアラートの数が表示されます。

「フロントエンドがAPIエラーを出している」という情報と、「フロントエンドがadServiceからHTTP 500エラーを受け取っている。この問題は24時間以内にすでに2回フラッピングしており、同じアラートグループで関連する3件のアラートが発火している」という情報とでは、大きな違いがあります。
ほかに何が影響を受けているかを把握する
次に、フロントエンドのエラーが単独の問題なのか、より大きな問題の一部なのかを見極める必要があります。プラットフォームチームにも呼び出しがかかっているかどうかも気になるところです。
多くのインシデント対応チームは、ダッシュボード、サービスマップ、オブザーバビリティ(可観測性)データ、SlackやTeamsを行き来しながらこれを調べています。
Slackのスレッドから、Grafana Assistantに「ほかに何が発火していて、どう関連しているか」と質問してみましょう。
Assistantは、いま見ているアラートと同じコンテキストを使い、回答を同じスレッドに投稿します。

SlackのメッセージにあるInvestigate this alertをクリックすると、発火しているアラートの概要と、次に確認すべき項目の提案がすぐに表示されます。
Assistantが見つけた内容は、あとからスレッドに加わったメンバーを含め、スレッドにいる全員が確認できます。追加で質問がある場合は、スレッド内で@Grafanaとメンションすれば、Assistantに続けて質問できます。

フロントエンドのエラー率を確認するクエリの作成や、必要なダッシュボードの検索も依頼できます。また、Skillsを使えば、サービス固有のプレイブックをAssistantに与えることも可能です。
インシデントを宣言する
チームで連携した対応が必要だと判断したら、IRMでインシデントを宣言します。
宣言すると、IRMが複数の作業を自動で実行します。毎回手動で作成する必要はありません。専用のSlackチャンネル、Zoom通話、そして根本原因の探索を始めるAI調査が、すぐに用意されます。
チームが作り忘れる心配もありません。システムが代わりに行います。

雑多な情報も取りこぼさない
役に立つ情報の多くは、重要かどうかがわからない段階でSlackに現れるものです。
チームメンバーが以前のデプロイを思い出し、フロントエンドのエラーの原因かもしれないと提案します。別のメンバーは依存関係について仮説を立てるかもしれません。さらに別のメンバーが、ダッシュボードで気になる点を見つけることもあるでしょう。
こうした情報の一部はインシデントレコードに残りますが、残りはSlackの履歴に埋もれてしまうのが普通です。
IRMでは、チームメンバーがSlackのメッセージにロボットの絵文字でリアクションするだけで、そのメッセージをインシデントのタイムラインに追加できます。元のメッセージ、投稿者、タイムスタンプも一緒に記録されるのは便利な点です。
裏付けのある説である必要はありません。全員がまだ状況を探っている間に、役立つ可能性のあるコンテキストを残すことが目的です。
Slackからインシデントを管理する
対応が始まると、インシデントコマンダーは、役割、タスク、コミュニケーション、他チームとの調整、そして実際の調査を同時にこなすことになるでしょう。
こうした作業は、Slackを離れずにインシデントチャンネル内で行えます。役割を割り当て、クイックアクションでタスクを作成し、それらのタスクをJiraまたはGitHubに同期できるため、インシデントのクローズ後もタスクが残るのも利点です。
ほかのチームの協力が必要な場合も、そのチームのオンコールスケジュールを探し回らず、同じ場所からチームを呼び出せます。さらに、「@Grafana assistant - who is on call?」と入力するだけでも確認可能です。
インシデントのオーナーが投稿したステータス更新は、Slackで共有されるとともにモバイルアプリにも通知されるため、関係者も状況を追えます。

中身を確認できるAIによる調査
AIによる調査は、インシデントを宣言した時点で自動的に始まります。
アラートデータ、紐づいたダッシュボードのパネル、タイムライン、Slackから追加された情報など、すでにあるコンテキストを取り込み、実際のデータと組み合わせて、問題の原因についての仮説を立て始めるのです。
Assistant Workspace機能は、エージェントと協力しながら、エージェントが何をしていて、何を見つけ、何を考えているかを追跡できる共同作業の環境です。
仮説を追加したり、却下された仮説を再度開いたり、反証されたものとしてマークしたり、調査に質問したりできます。結論の根拠となったソースを確認することも可能です。

根本原因の提案は、ブラックボックスを信じるかどうかを判断するのではなく、根拠を確認できてこそ役に立ちます。MCPインテグレーションを通じて、Grafana外の情報も関連付けられます。たとえば、先ほどのデプロイに関する仮説をGitHubで直接確認し、エラーとの関連を示す証拠は見つからなかった、という結果になりました。調査は、adServiceのエラーが500レスポンスとしてフロントエンドに届いていることを、原因として指摘しています。もとはSlackのふとしたメッセージだったことは関係ありません。インシデントのコンテキストに入れば、ほかの情報と同じように評調査は、adServiceのエラーが500レスポンスとしてフロントエンドに届いていることを、原因として指摘しています。価されます。


インシデントの解決:モバイルアプリで完結!
AIによる調査の助けを借りて根本原因を突き止め、問題を緩和する修正も適用できました。ポストインシデントレビュー(PIR)を書く必要があることはわかっていても、全員が通常業務に戻ると、つい忘れてしまいがちです。
Grafanaモバイルアプリがあれば、インシデント対応中でも、自分の次のオンコールシフトを調整するときでも、スマートフォンから作業を続けられます。
そのため、すぐにPIRに取りかかれず、詳細の記憶があいまいになったとしても、インシデントレコード、タイムライン、調査、仮説、ソースはすべてモバイルアプリで確認できるので安心です。
スマートフォンで調査を開き、Assistantにポストインシデントレビューの作成とConfluenceへの送信を依頼するだけです。レビューは、チームが対応中にすでに使った履歴と根拠から生成されます。タイムラインを記憶から再構築する必要はありません。

そのついでに、自分の次のオンコールシフトがいつ始まるかも確認できます。
モバイルでのワークフロー全体は、下の動画で詳しく確認してください。
まとめ:使い慣れたツールで、インシデント対応を途切れさせない
チームは、これまでどおりSlackで作業し、通話に参加し、使い慣れたツールでレビューを書けます。インシデントレコードが、それらの作業をつなぎ合わせてくれるのです。Grafana Cloud IRMを使って、実際のアラートでどのように動作するかを確認してください。ObservabilityCON 2026が開幕しました! 主要な発表をまとめたブログ記事もチェックしてください。
Grafana Cloudは、メトリクス、ログ、トレース、ダッシュボードなどを始める最も簡単な方法です。私たちは、充実した永久無料枠と、あらゆるユースケース向けのプランを用意しています。今すぐ無料でアカウントを作成しましょう!